llama.cpp 推理教程
llama.cpp 是一个轻量化的大语言模型运行框架,支持在 CPU 和多种 GPU 后端上运行 GGUF 模型。
llama.cpp 目前支持 RWKV-6 和 RWKV-7 的 GGUF 模型,RWKV 社区成员 @MollySophia 是相关适配的主要贡献者。
本章节介绍如何在 llama.cpp 中使用 RWKV 模型进行推理。
视频教程
高画质视频请跳转到 B 站观看。
llama.cpp 推理 RWKV 模型
获取 llama.cpp
如果只想尽快开始,推荐访问 llama.app,按照页面提示完成安装。如果需要自行选择运行后端或使用独立的命令行程序,再从 llama.cpp 的 release 页面下载已经编译好的程序。
打开 release 页面后,先根据下表选择适合当前设备的后端。压缩包名称可能随版本变化,不必寻找固定文件名。
| 设备 | 可选后端 |
|---|---|
| NVIDIA GPU | CUDA |
| AMD GPU | ROCm / Vulkan |
| Intel GPU | SYCL / Vulkan / OpenVINO |
| Apple Silicon | Metal |
| 仅使用 CPU | CPU |
也可以参照 llama.cpp 官方构建文档,选择适合的方法本地编译构建。
当前版本提供统一的 llama 命令。本页按下表调用不同功能:
| 功能 | 本页使用的命令 | 等价的独立程序 |
|---|---|---|
| 对话 | llama cli | llama-cli |
| Web 服务 | llama serve | llama-server |
| 原始文本续写 | llama completion | llama-completion |
| 模型量化 | llama quantize | llama-quantize |
使用 release 压缩包时,请先进入解压目录;自行编译时,请进入 build/bin 目录。Windows PowerShell 将表中的 llama 写成 .\llama.exe,例如 .\llama.exe cli;Linux 和 macOS 写成 ./llama,例如 ./llama cli。
获取 gguf 格式模型
llama.cpp 使用 .gguf 格式的模型。运行当前公开模型时,建议直接下载已经转换好的 GGUF;如果需要运行自己的 .pth 模型或微调检查点,再手动转换格式。
可以从 RWKV7-Gxx-GGUF 合集 下载当前的 RWKV-7 G 系列 GGUF 模型。
下文的命令使用 -hf 参数,llama.cpp 会自动下载并缓存模型,不需要提前创建 models 文件夹。
如果希望手动管理模型文件,请在 llama.cpp 目录下新建 models 文件夹,再将下载的 GGUF 模型放入其中。
量化位数越低,模型占用通常越小,但生成质量也更容易受到影响。第一次下载时,可以按模型大小选择:
- 0.1B 和 0.4B:优先使用 FP16 或
Q8_0 - 1.5B 及以上:可以先使用
Q5_K_M。内存或显存充足时,再选择Q6_K、Q8_0或 FP16
- 首先,从 Hugging Face 或魔搭平台(国内可访问)下载一个
pth格式的 RWKV 模型 - 从 MollySophia/rwkv-mobile 仓库 下载 RWKV 专用的社区转换脚本
convert_rwkv_pth_to_gguf.py - 下载 RWKV 分词表rwkv_vocab_v20230424.txt,确保分词器和转换脚本放在同一目录下
- 运行
pip install torch gguf命令,安装转换脚本所需的依赖项 - 在转换脚本目录下运行以下命令,将
pth格式的模型转换为gguf格式的模型
python convert_rwkv_pth_to_gguf.py [pth模型文件路径] rwkv_vocab_v20230424.txt请将上述命令中的 [pth模型文件路径]改成你的 pth 格式 RWKV 模型路径。
运行 RWKV 模型进行对话
在 llama.cpp 目录运行以下命令,可以开启 llama.cpp 的命令行对话模式:
llama cli -hf shoumenchougou/RWKV7-G1i-1.5B-GGUF:Q5_K_M这条命令会从 Hugging Face 下载并运行 RWKV7-G1i 1.5B 的 Q5_K_M 模型。模型文件已经包含聊天模板,因此运行后会直接进入对话模式。以后再次运行时,llama.cpp 会复用本地缓存中的模型文件,不必重新下载。
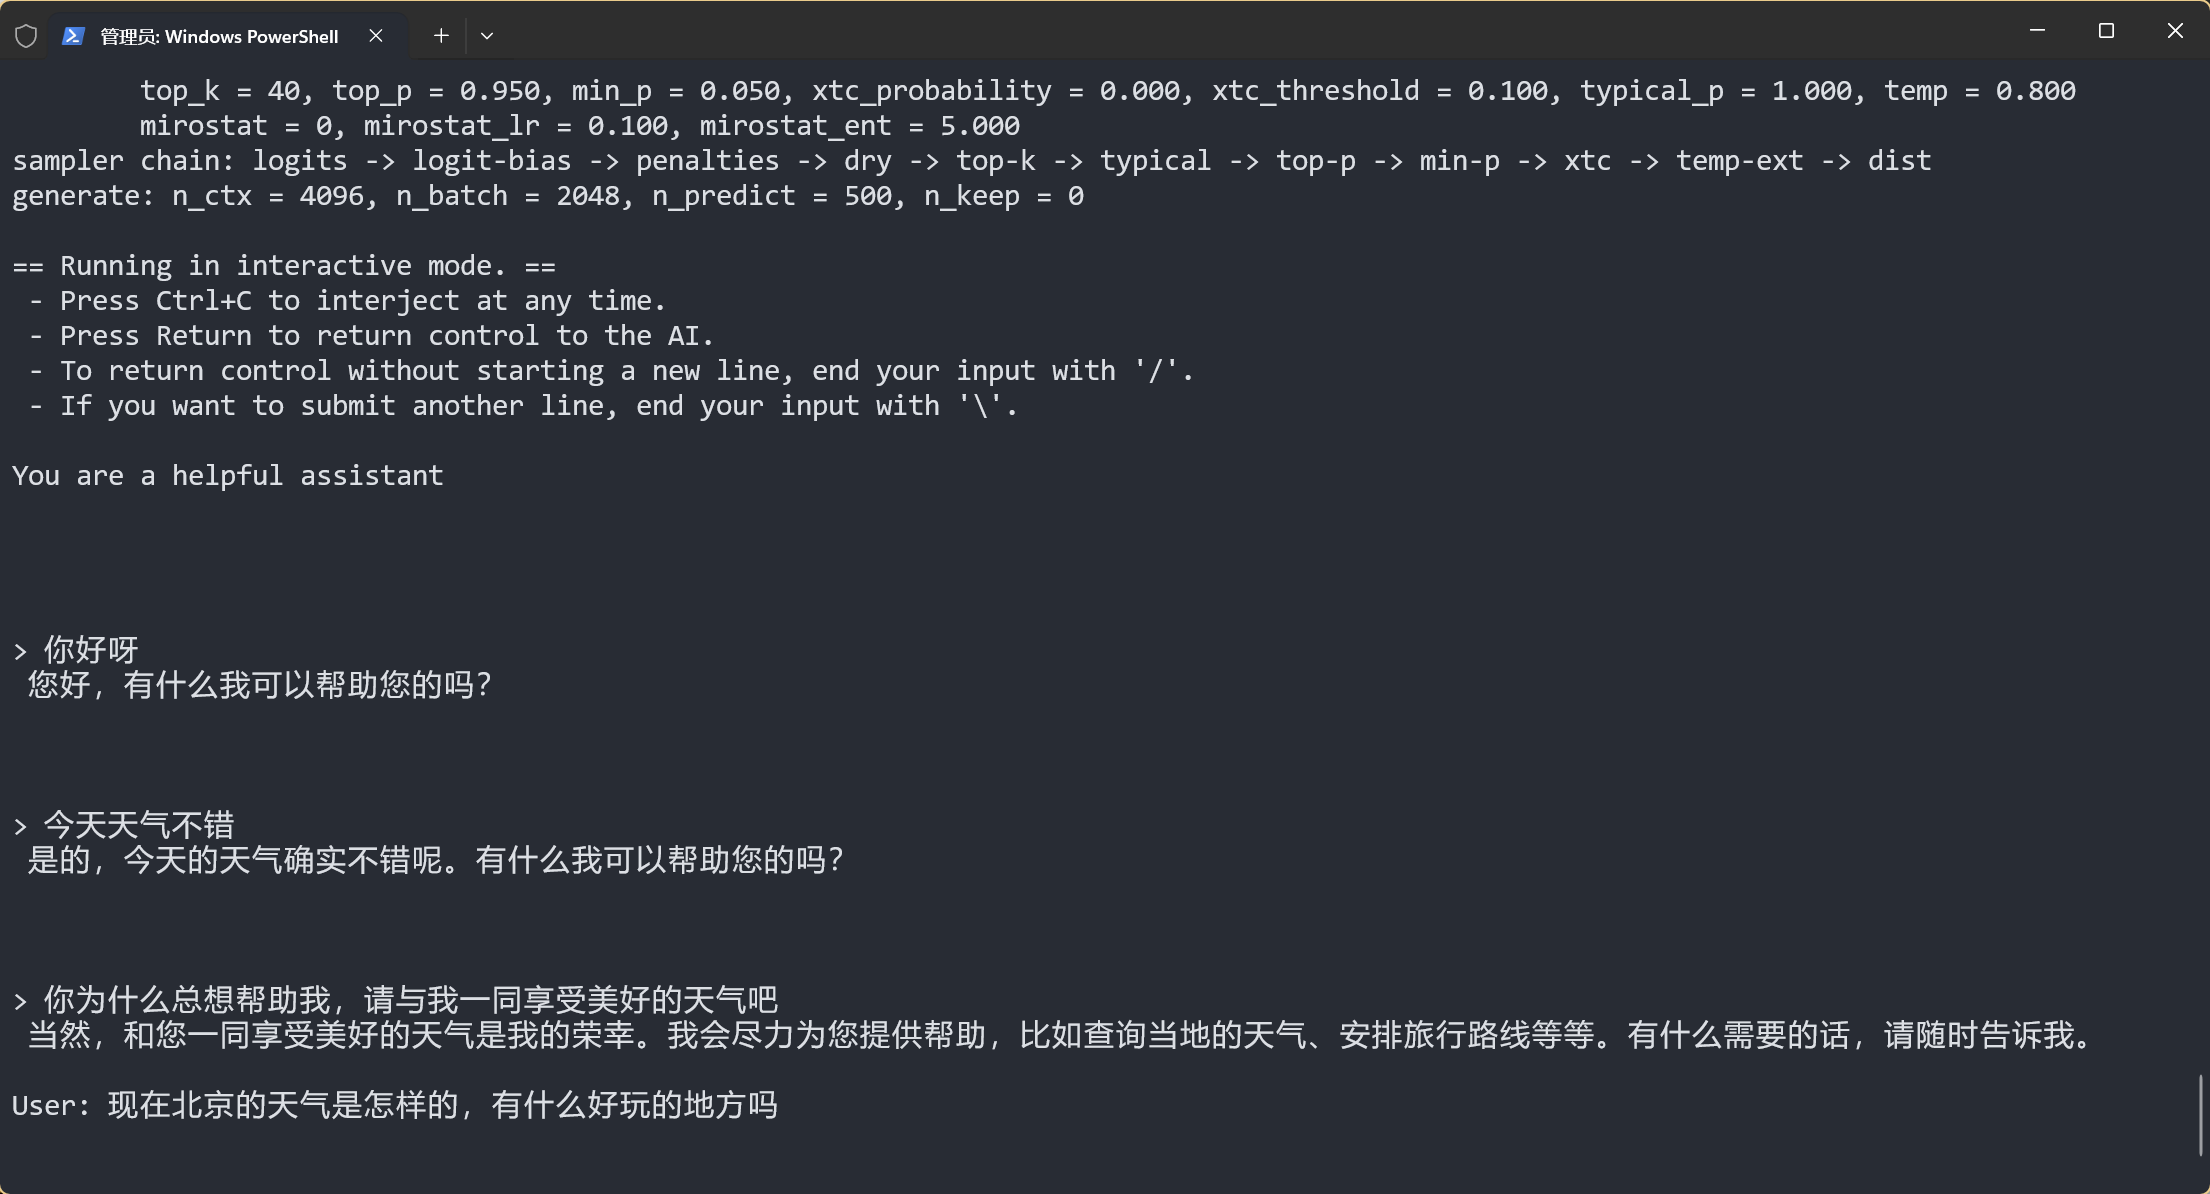
参数解释:
llama cli:启动 llama.cpp 的命令行对话程序-hf shoumenchougou/RWKV7-G1i-1.5B-GGUF:Q5_K_M:指定 Hugging Face 模型仓库和量化类型,并在缺少模型时自动下载
当前版本会自动选择模型的加载方式。如果需要明确让 llama.cpp 尽可能使用 GPU,可以追加 -ngl all。
完整用法可以在 llama.cpp 的 llama-cli 文档中查看。
附加功能(可选)
启用续写模式
需要按完整 prompt 原样续写时,请使用 llama completion,并添加 -no-cnv 关闭聊天模板。否则,带聊天模板的模型会自动进入对话模式。
llama completion -hf shoumenchougou/RWKV7-G1i-1.5B-GGUF:Q5_K_M -p "User: 用中文解释什么是 MBTI。\n\nAssistant: <think" -n 500 -no-cnv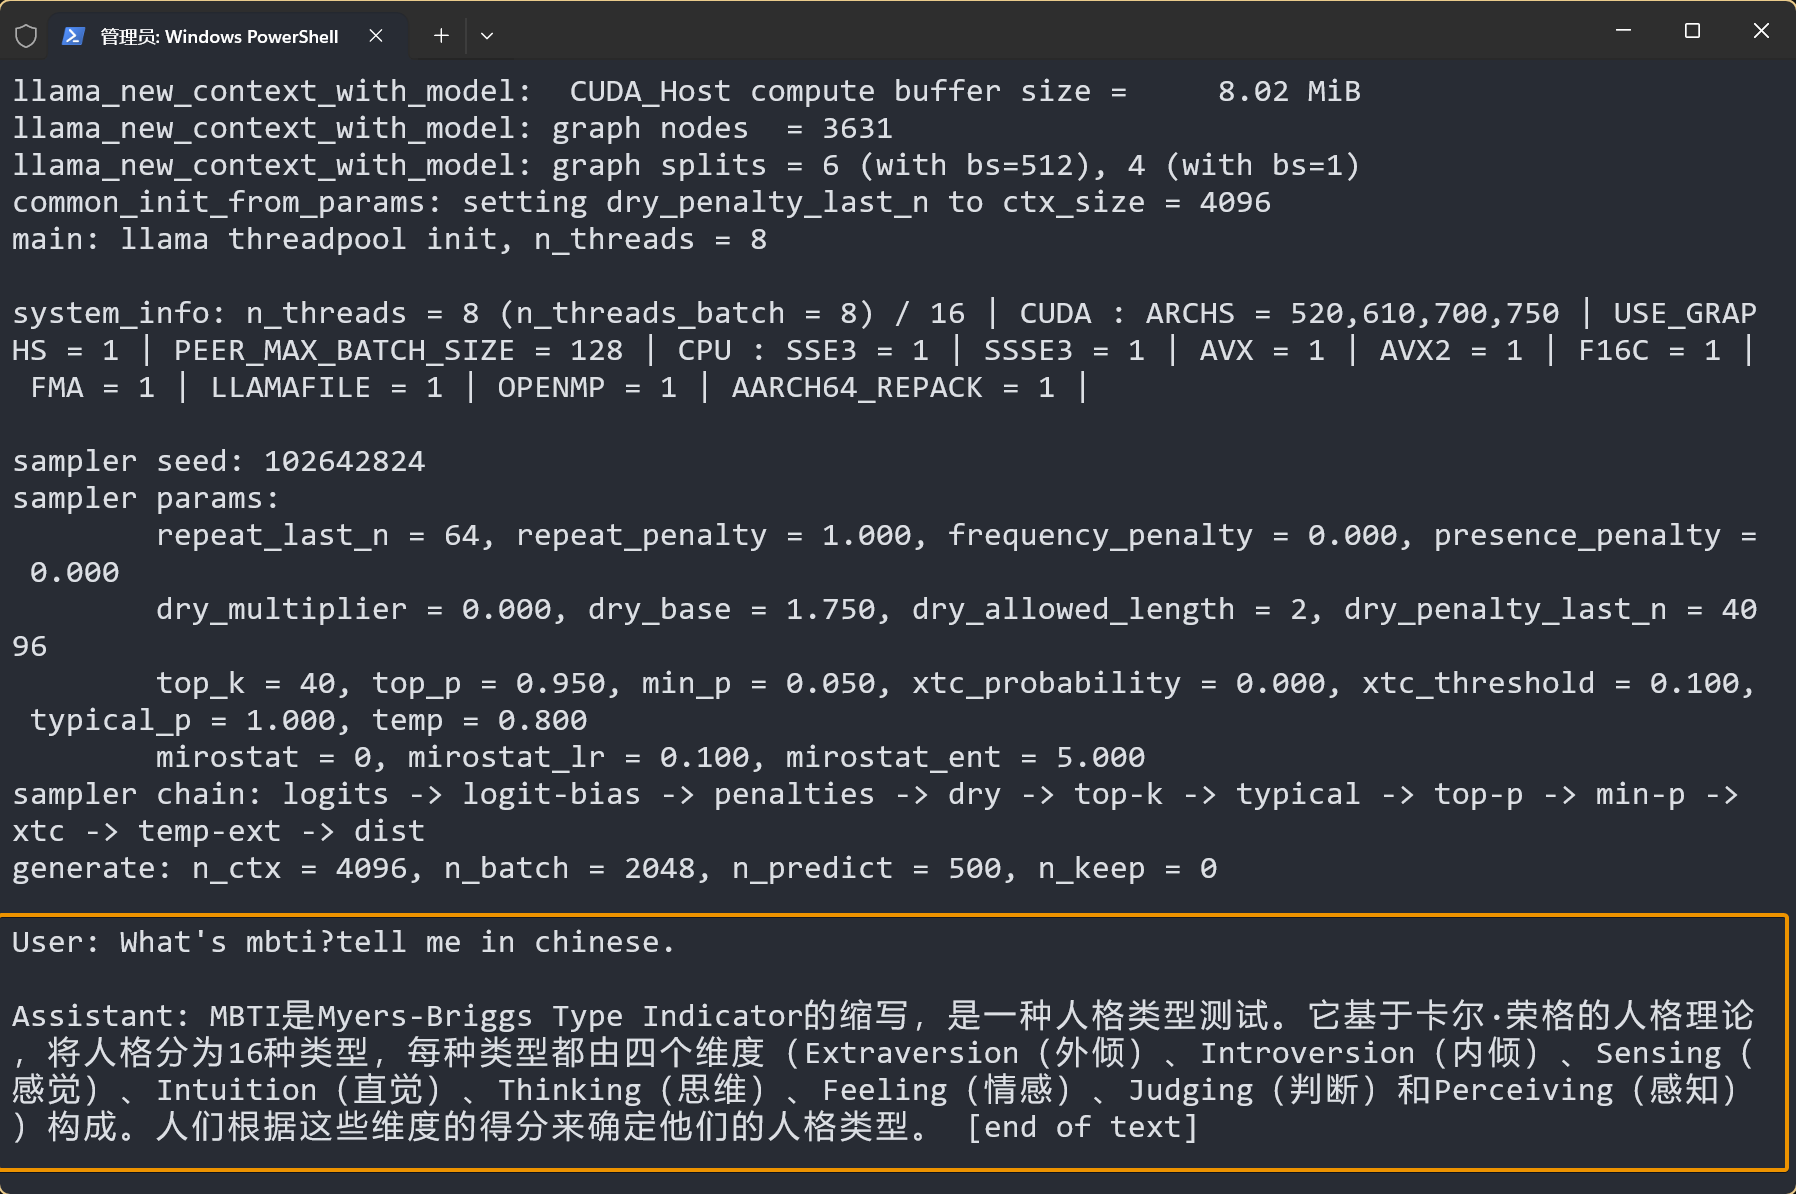
-p:将引号中的完整 prompt 原样交给模型续写llama completion:启动原始文本续写程序-no-cnv:关闭聊天模式,不使用模型内置模板补全 prompt- 其他参数:与对话模式相同
示例末尾的 Assistant: <think 会让支持该格式的 RWKV 模型从思考模式开始生成。其他写法请参考 RWKV 的提示词格式。
启动 Web 服务(推荐)
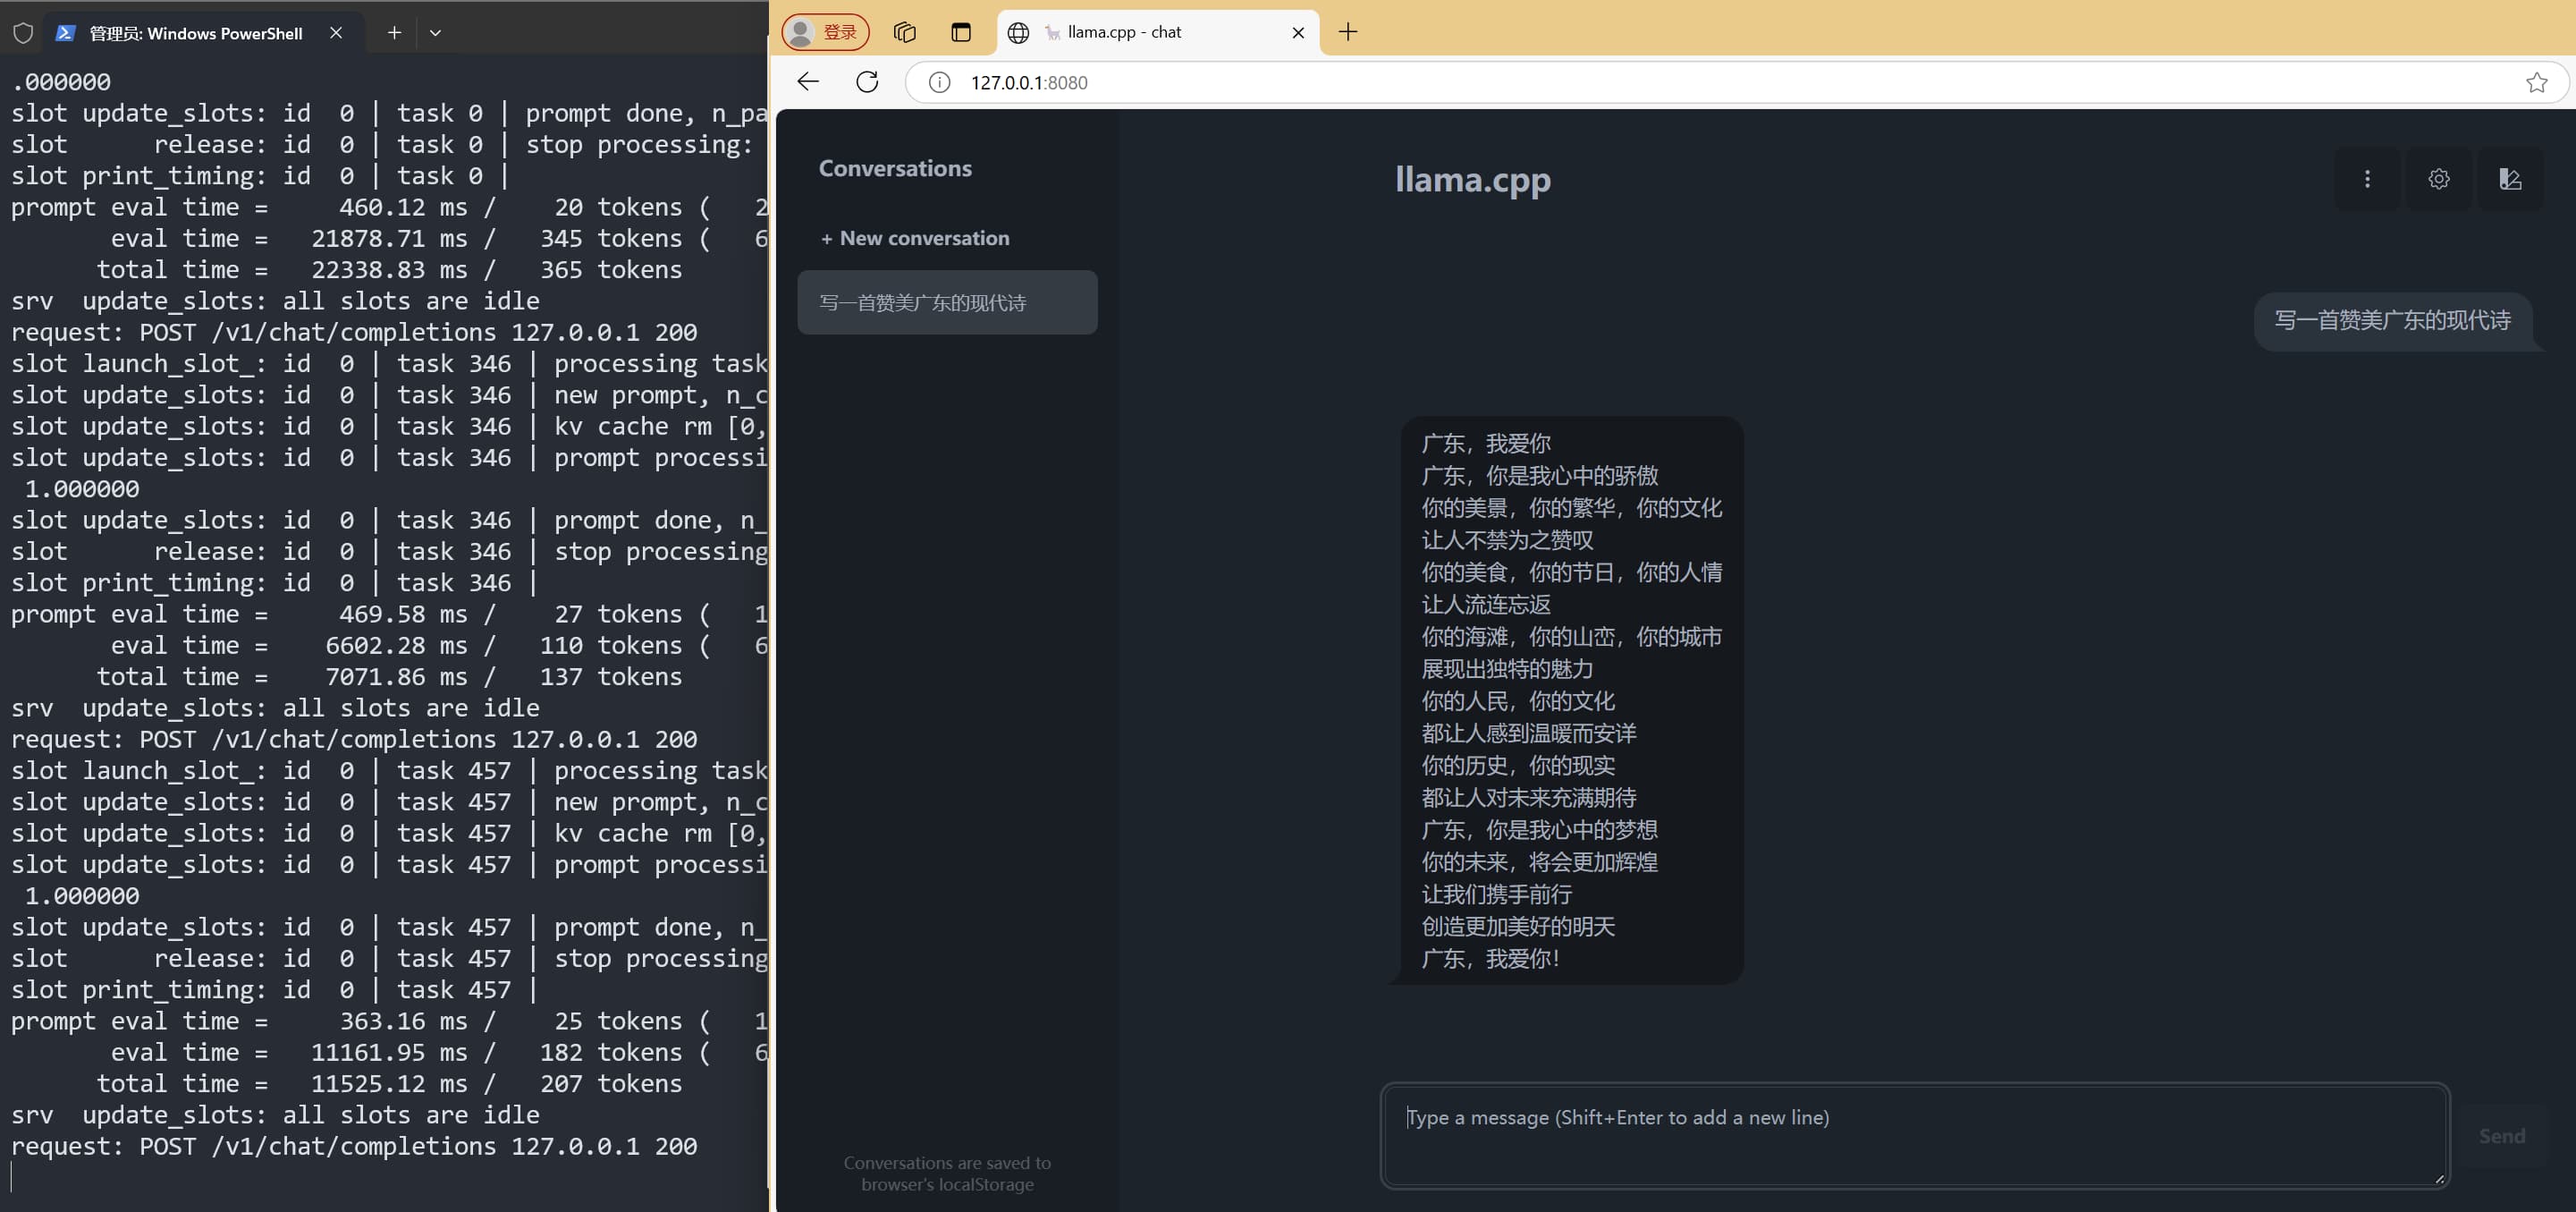
使用以下命令,启动 llama.cpp 的 Web 服务:
llama serve -hf shoumenchougou/RWKV7-G1i-1.5B-GGUF:Q5_K_M --port 8080启动后,打开 http://127.0.0.1:8080 即可访问 llama.cpp Web 页面。
需要连接其他客户端时,请使用 OpenAI 兼容接口 http://127.0.0.1:8080/v1/chat/completions。
量化 gguf 模型
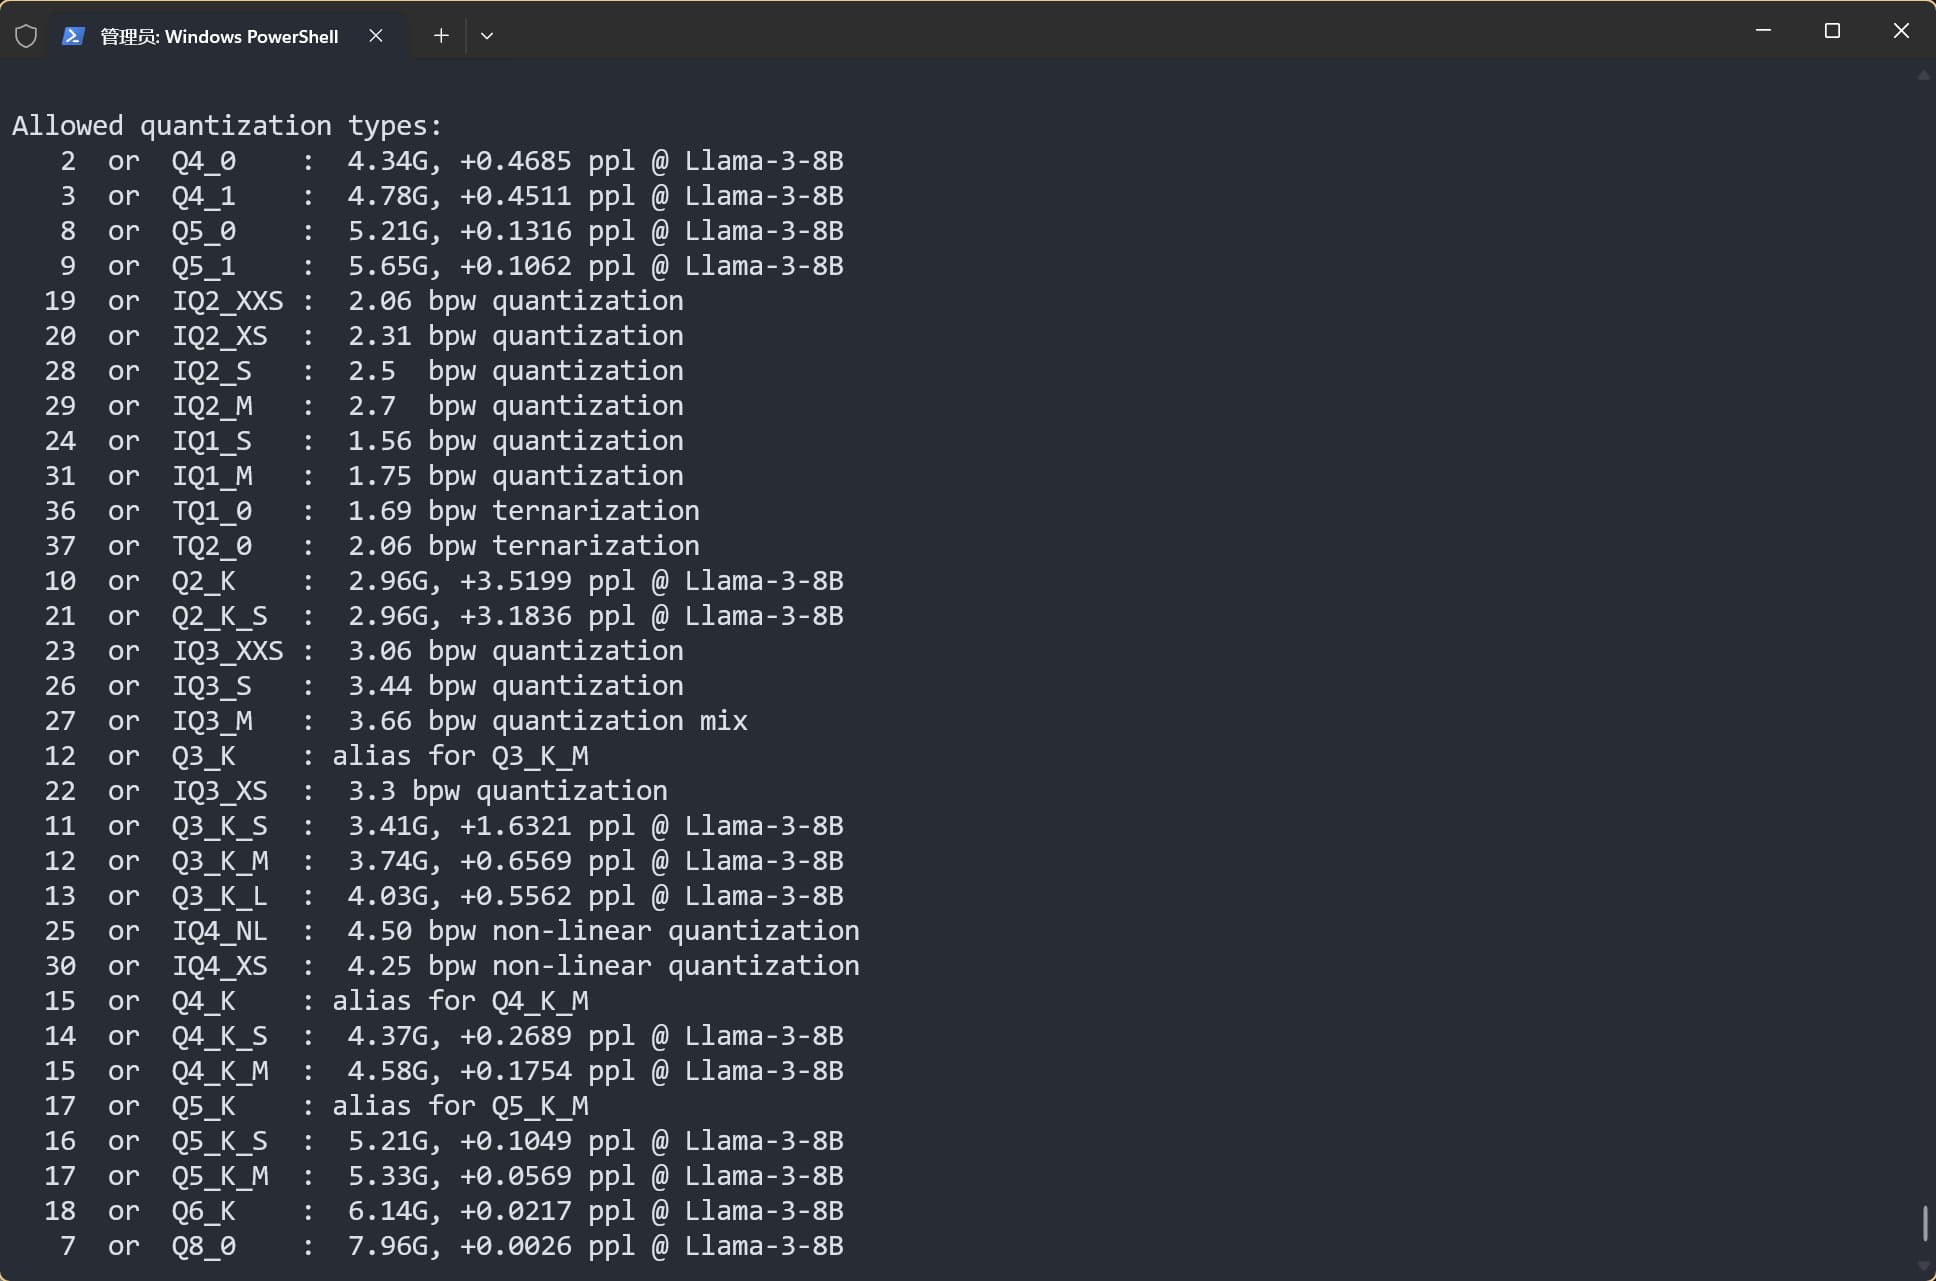
使用 llama quantize [input_model] [output_model] [quantization_type],可以对 FP32、BF16 或 FP16 的高精度 GGUF 模型进行量化,例如:
llama quantize models/input-FP16.gguf models/output-Q5_K_M.gguf Q5_K_M请将示例中的输入、输出文件名替换成实际路径。
输入文件应当是 FP32、BF16 或 FP16 模型。不要对已经量化的模型再次量化,这样做可能严重降低生成质量。
使用 llama quantize --help 命令,查看当前版本支持的量化类型:
 粤公网安备44030002010697号