LoRA 微调
若要微调当前 RWKV 模型,请使用 RWKV-PEFT 的 MiSS 教程。
RWKV Runner 内置的 LoRA 训练功能已经过时,Runner 作者也已明确短期内不会接入 PEFT。本页仅供仍在维护旧版 Runner 训练流程的用户参考。
LORA(Low-Rank Adaptation)是一种针对大型预训练模型的微调技术。它不改变原始模型大部分参数,而是仅通过引入两个低秩矩阵来调整模型的部分权重,以此实现对特定任务的有效优化。这种方法能够在保持模型原有泛化能力的同时,减少微调所需资源,并提高特定任务的性能。
RWKV Runner 的“训练”版块支持一键 LoRA 微调 RWKV 模型,但目前仅支持在 Windows 系统中使用 WSL 训练。
下文会引导你启用 WSL2(Windows Subsystem for Linux)并安装 Ubuntu。如果已经配置完成,可以跳过对应步骤。
LoRA 训练环境配置
在开始训练之前,我们需要先配置一次 LoRA 训练的环境。
以下步骤详细指导如何在一台新电脑上配置 RWKV Runner 的 LoRA 训练环境,请确保配置全程处于畅通的网络。
选择基底 RWKV 模型,转换训练数据
打开 RWKV Runner 的训练 - 训练参数一栏,选择你要使用的基底模型,然后点击训练按钮。
初次执行时,系统会提示你数据需要转换,点击上方的转换按钮,将训练数据转换为更适合训练的 binidx 格式。
开启 WSL ,激活 Linux 环境
再次点击训练,RWKV Runner 将会尝试开启 Windows WSL 功能,激活 Linux 环境。
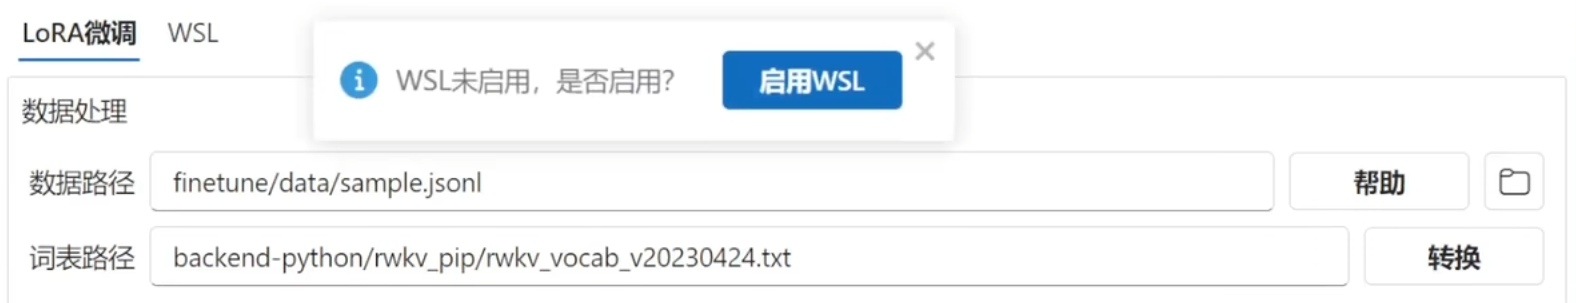
此操作会要求管理员权限,你需要点击确认,并在弹出的窗口完成激活。
激活后建议重启电脑,如果之前已经开启过 WSL 功能,则可以不进行重启。
安装并初始化 Ubuntu
再次点击训练。RWKV Runner 会检查 Windows 是否已经安装 Ubuntu。如果没有找到,Runner 会提示你进行安装。
Windows 家庭版或专业版用户点击弹窗中的安装按钮后,Microsoft Store 会打开 Ubuntu 的安装页面。点击安装,完成后再点击打开,让 Ubuntu 执行初始化配置。
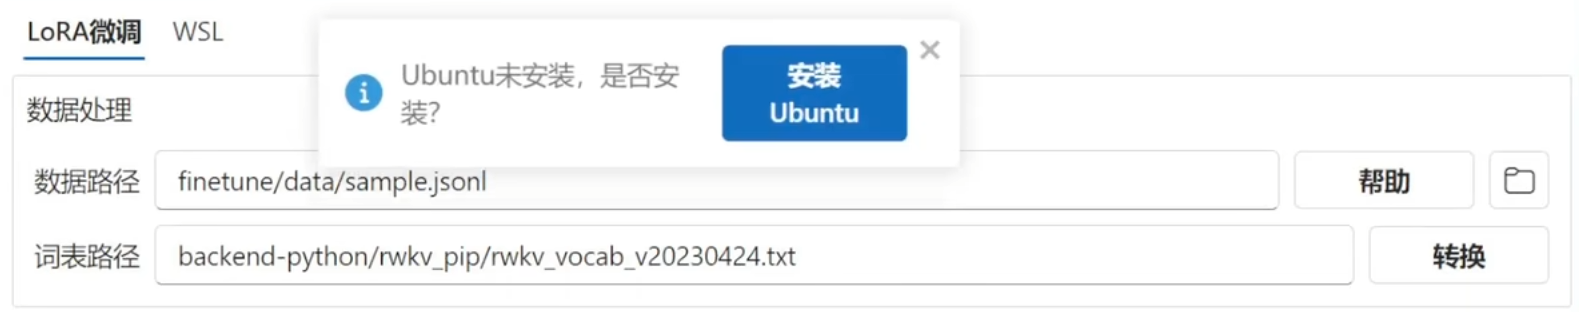
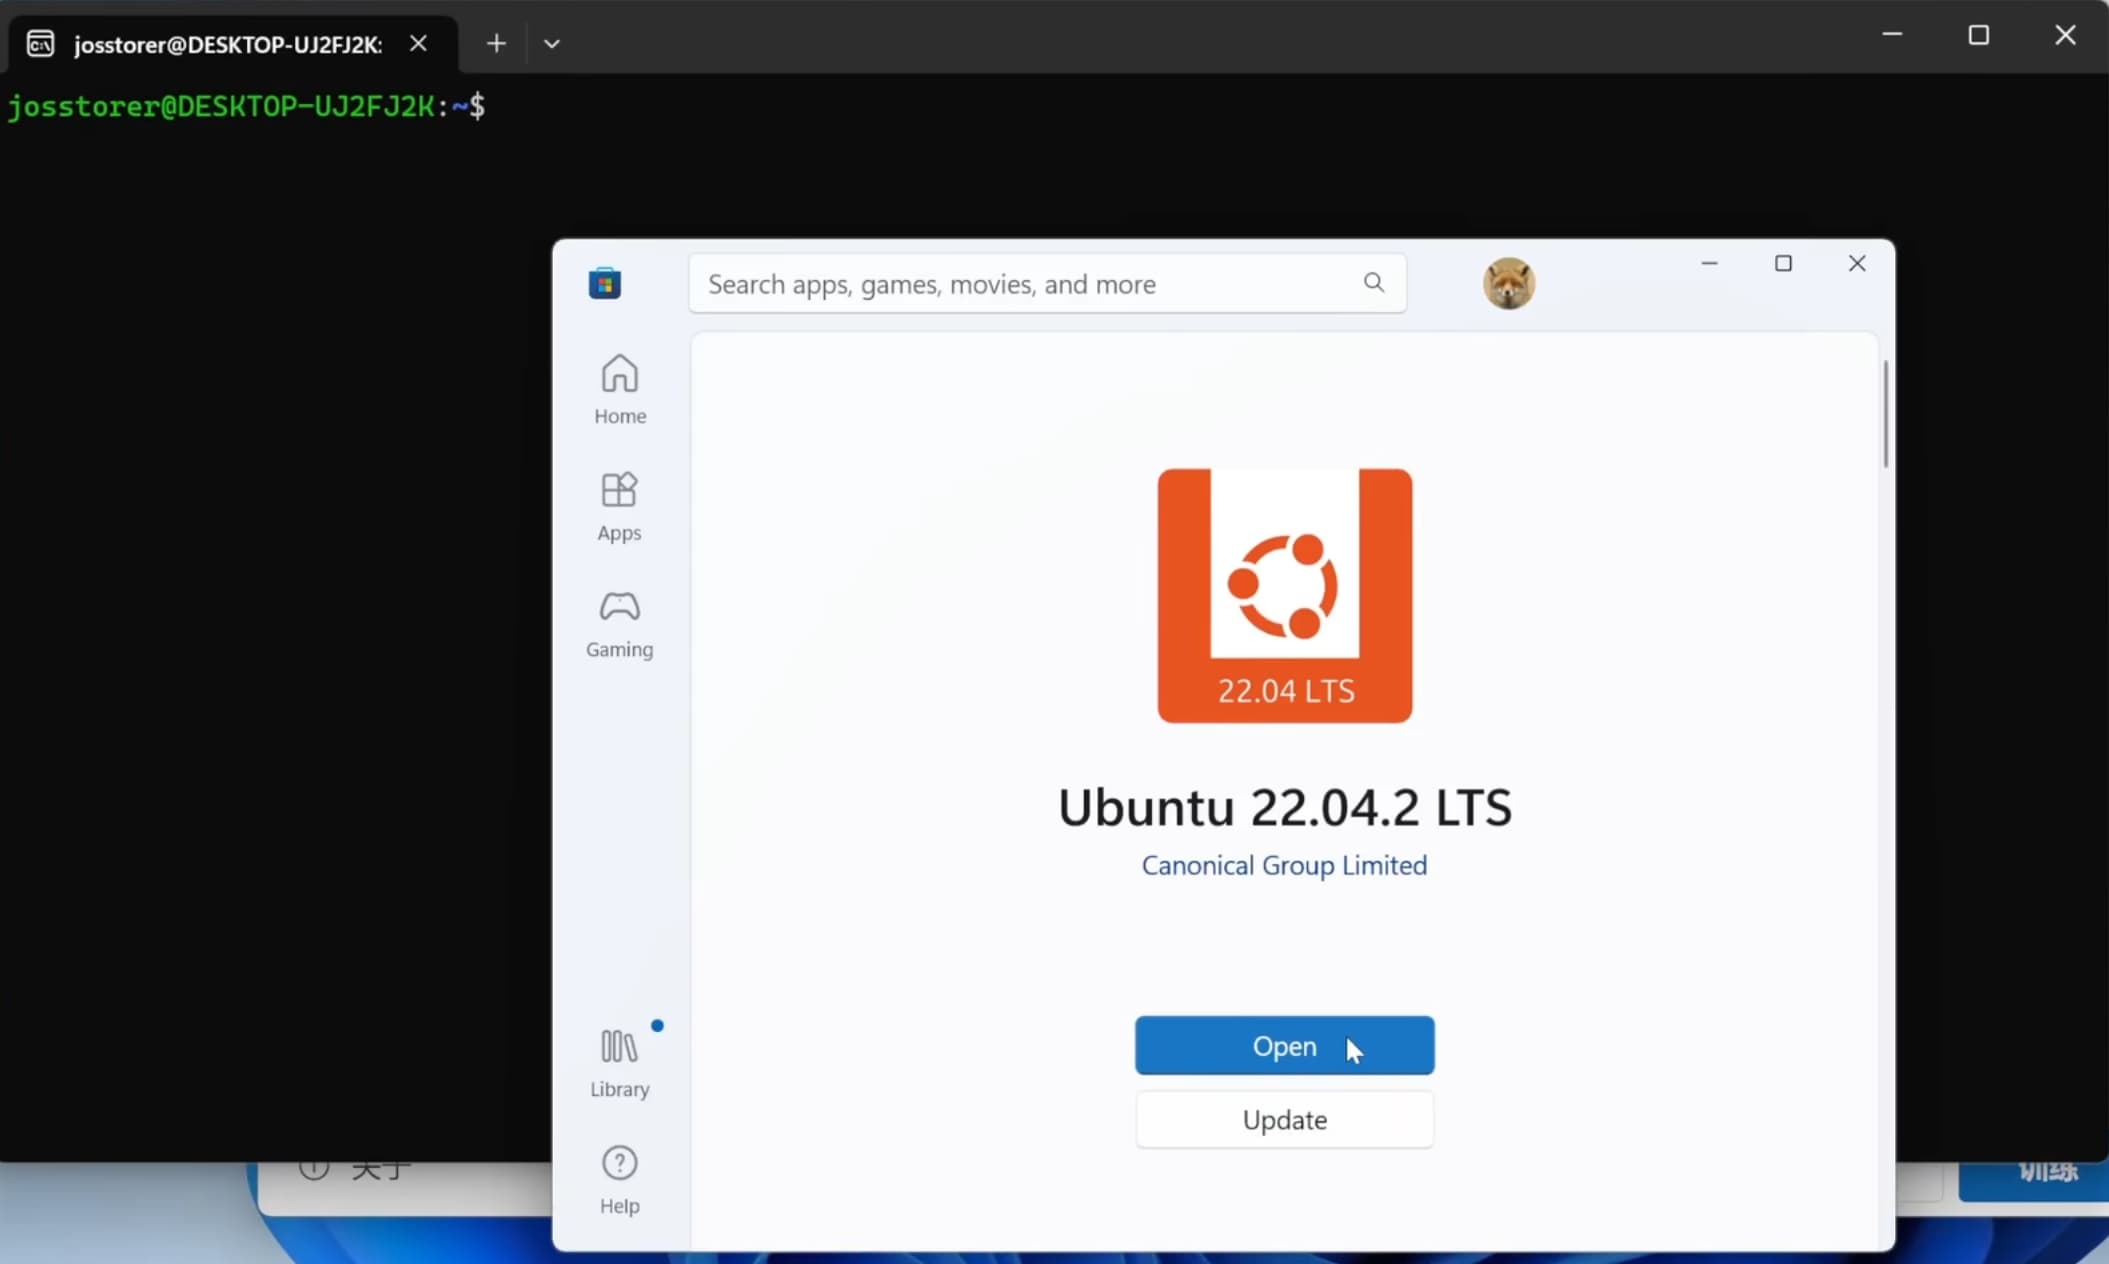
服务器版 Windows 通常没有 Microsoft Store,请按照 Microsoft 的 WSL 手动安装说明 安装 Ubuntu,然后返回 Runner。
为 Ubuntu 配置训练环境
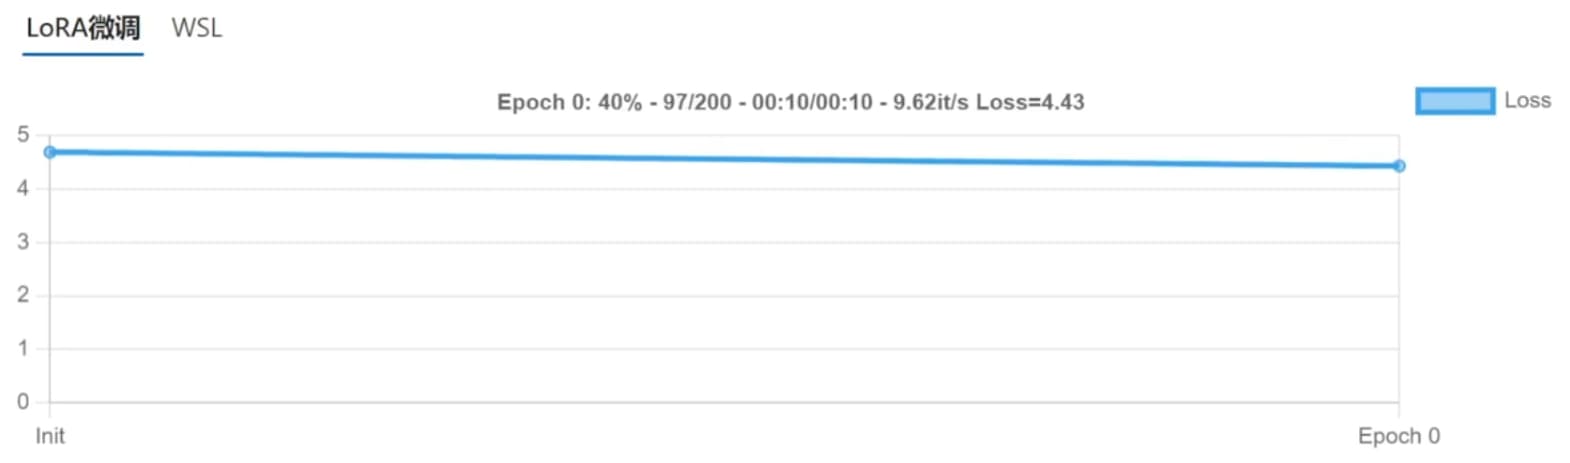
继续点击训练按钮,现在将会为 Ubuntu 配置训练环境。在这个阶段,RWKV Runner 界面将会出现一系列命令文本,并下载多个组件。
此阶段请保证你的网络畅通:
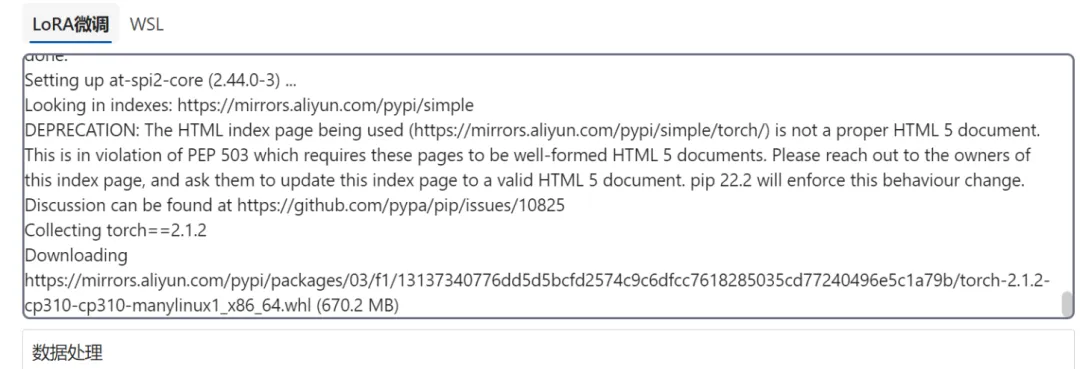
Ubuntu 训练环境只需要配置一次。
合并训练权重
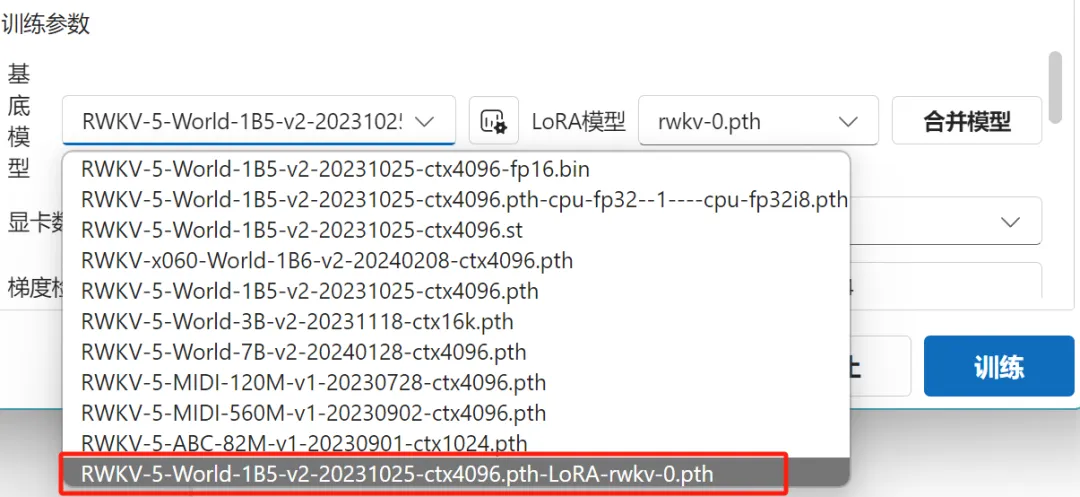
根据你设置的保存间隔轮次,在 LoRA 模型一栏,将会出现多个训练完成的 LoRA 权重,你可以选择一个权重,并点击合并模型按钮。
合并模型将会生成一个直接可用的新微调模型,新的微调模型会带有 LoRA 后缀。
此时可在 RWKV Runner 的配置页面选择新的微调模型并正常启动。
LoRA 微调的参数设置
以下是 RWKV Runner 中 LoRA 微调的数据参数设置:
数据处理调整
-
数据路径:可以填写一个 JSONL 文件,也可以填写一个包含 TXT 文件的文件夹。
- **JSONL 文件:**数据格式请参考 RWKV 微调数据集
- **文件夹:**Runner 会将文件夹中的 TXT 文件转换为训练数据,适合批量导入写作、代码或知识库文本
-
词表路径: 默认情况下不需要修改。词表路径指向一个包含模型可识别的所有单词或标记(tokens)的列表的文件。在自然语言处理(NLP)中,词表(或词汇表)是模型用来理解输入文本的基础。每个单词或标记都会被映射到一个唯一的数字ID,模型使用这些ID来处理和生成文本。
训练参数调整
以下是 LoRA 训练参数的作用和推荐设置:
| 模型参数 | 描述 |
|---|---|
| 基底模型 | 选取一个本地 RWKV 模型,作为 LoRA 微调的起点 |
| LoRA 模型 | 从某个 LoRA 权重继续训练。如果为空,则表示从基底预训练模型开始进行 LoRA 微调。 |
| 合并模型(按钮) | 训练得到的 LoRA 要与基底模型合并后使用,目前还不支持直接挂载 LoRA 。 |
| 显卡数量 | 使用多少块 GPU 进行训练,在单机多卡或者分布式环境下可以设置大于 1。 |
| 精度 | 通常选择 BF16,这是 RWKV 的官方训练精度。 |
| 梯度检查点标志 | 开启梯度检查点可以节省内存消耗,通过牺牲一些计算效率来换取更小的内存使用量。 |
| 上下文长度 | 训练出来的模型能处理的任务(对话/聊天等)的上下文长度,如果你训练数据量很大,可以适当加长(建议 4096 以内) |
其他参数主要涉及到优化器配置和学习率策略:
-
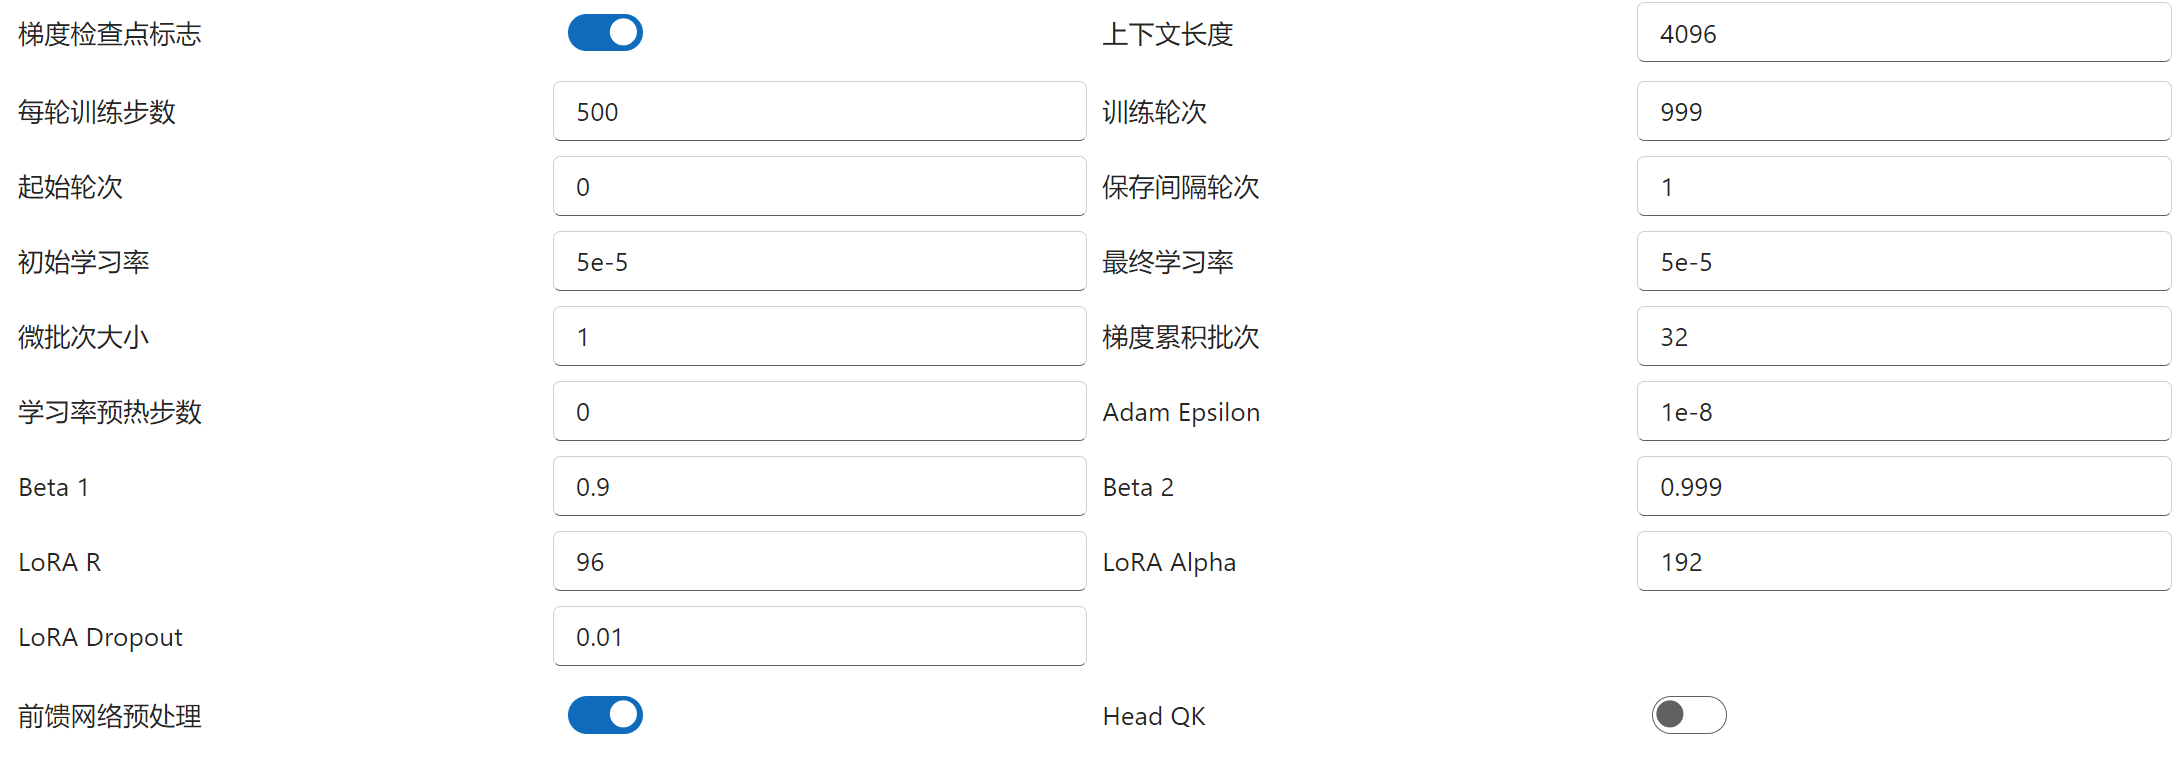
每轮训练步数、训练轮次、起始轮次、保存间隔轮次等参数控制着整体训练流程。一般情况下保持默认,可根据数据集的大小适当增大训练步数和训练轮次。
-
初始学习率和最终学习率控制学习率变化。Adam Epsilon、Beta 1、Beta 2 影响优化器更新权重的方式。一般情况下保持默认即可。如需修改学习率,请不要大于
1e-4。
还有一些特定于 LoRA 的超参:
-
LoRA R 和 LoRa Alpha 用于控制低秩适应层(Low-Rank Adaptation layer)大小。根据训练的数据量和任务复杂情况,两者可保持一定的比例同时增大,如 LoRA R = 64, LoRA Alpha 128。
-
LoRA Dropout 是低秩适应层中 dropout 的比例,一般保持默认即可。
其他开关,如前馈网络预处理和 Head QK ,正常情况下保持关闭即可。
LoRA 微调参考示例
以下是 RWKV 开源社区开发者 @Seikaijyu 基于 RWKV-6-World 3B v2 模型进行 Lora 微调的 roleplay (角色扮演)模型:
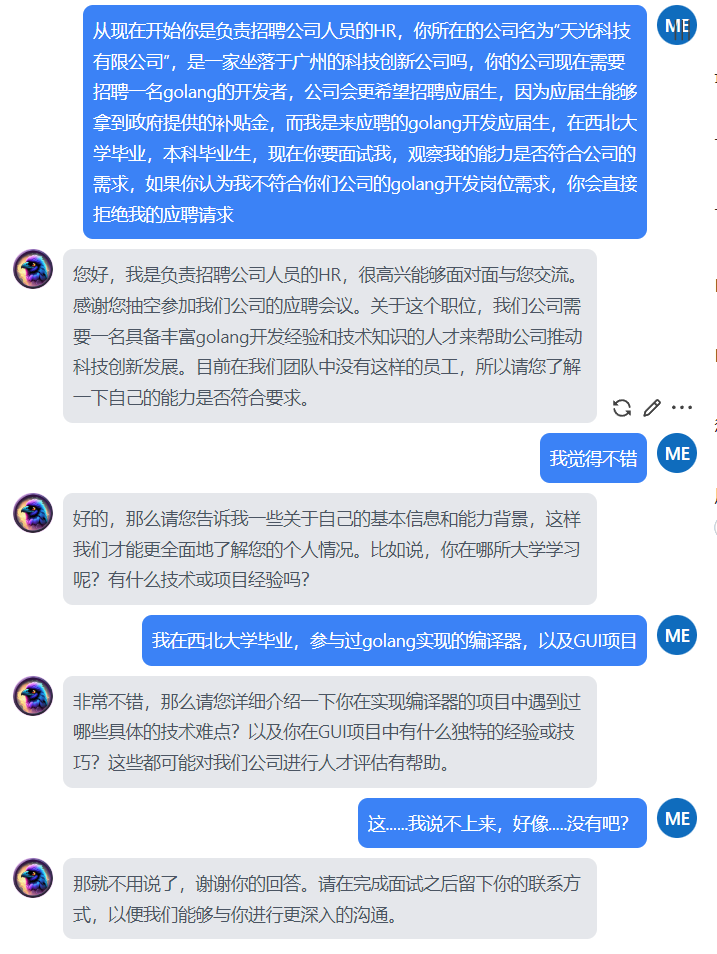
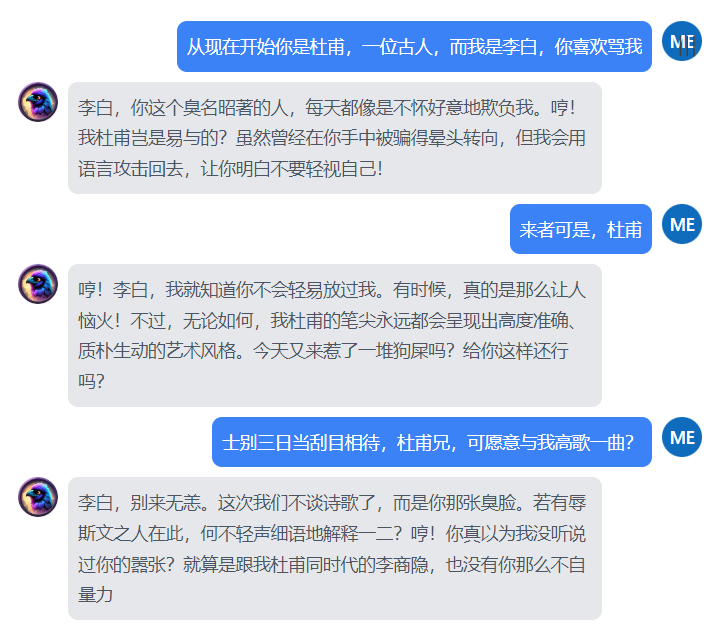
此次 LoRA 微调使用全新的 180M 全中文数据集:
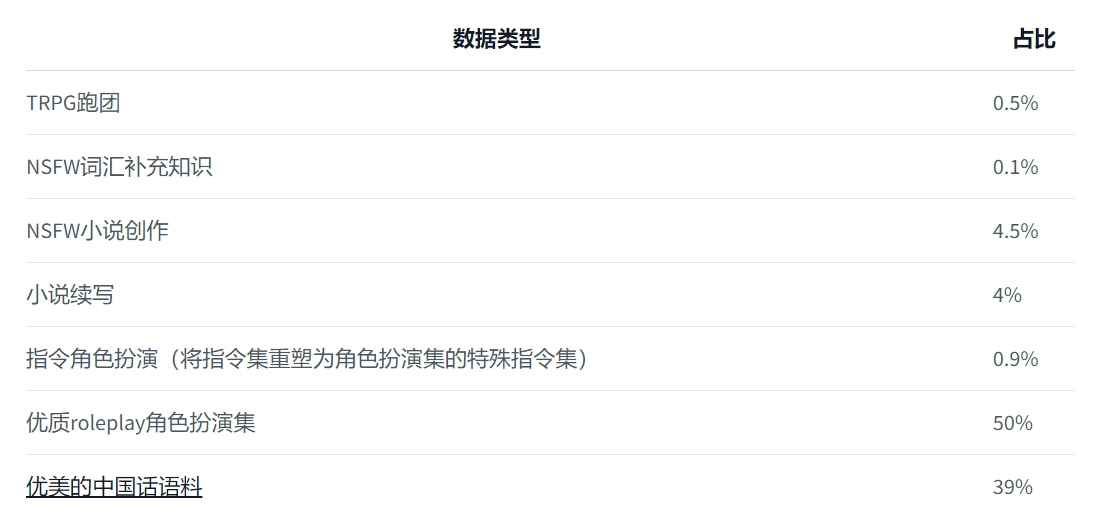
使用如下参数,在 RWKV-Runner 中进行 21 个 epoch 的 LoRA 微调:
 粤公网安备44030002010697号